
ランダムサンプリングとは?種類5つと誤差を防ぐ計算式を徹底解説
- 2024/09/17
- 2026/08/27
SHARE


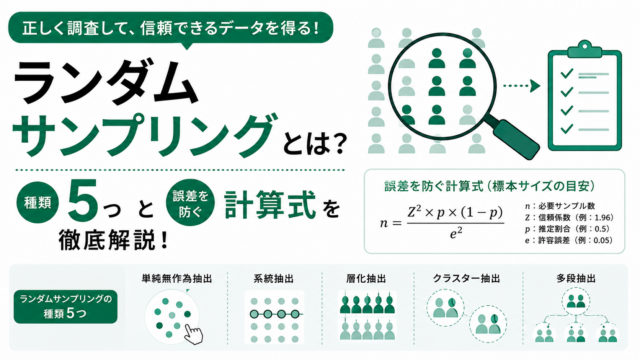
ランダムサンプリング(無作為抽出)は、母集団から偏りなく標本を選び、少ない回答数で全体の傾向を高い精度で推定するための調査手法です。しかし実務では「どの種類を選べばいいのか」「何件集めれば信頼できるのか」で迷い、結果として使えないデータになってしまうケースが後を絶ちません。
本記事では、ランダムサンプリングの5つの種類の使い分け、サンプルサイズの計算式と早見表、Excel・スプレッドシート・Pythonでの具体的な抽出手順までを一気通貫で解説します。
読み終えるころには、自社の調査目的に合った抽出方法を選び、誤差を数値で説明できる状態になります。マーケティング・営業・人事・品質管理でアンケートや調査を担当する方に向けた実務ガイドです。
著者:Interviewz編集部(運営:LEARNERZ株式会社)
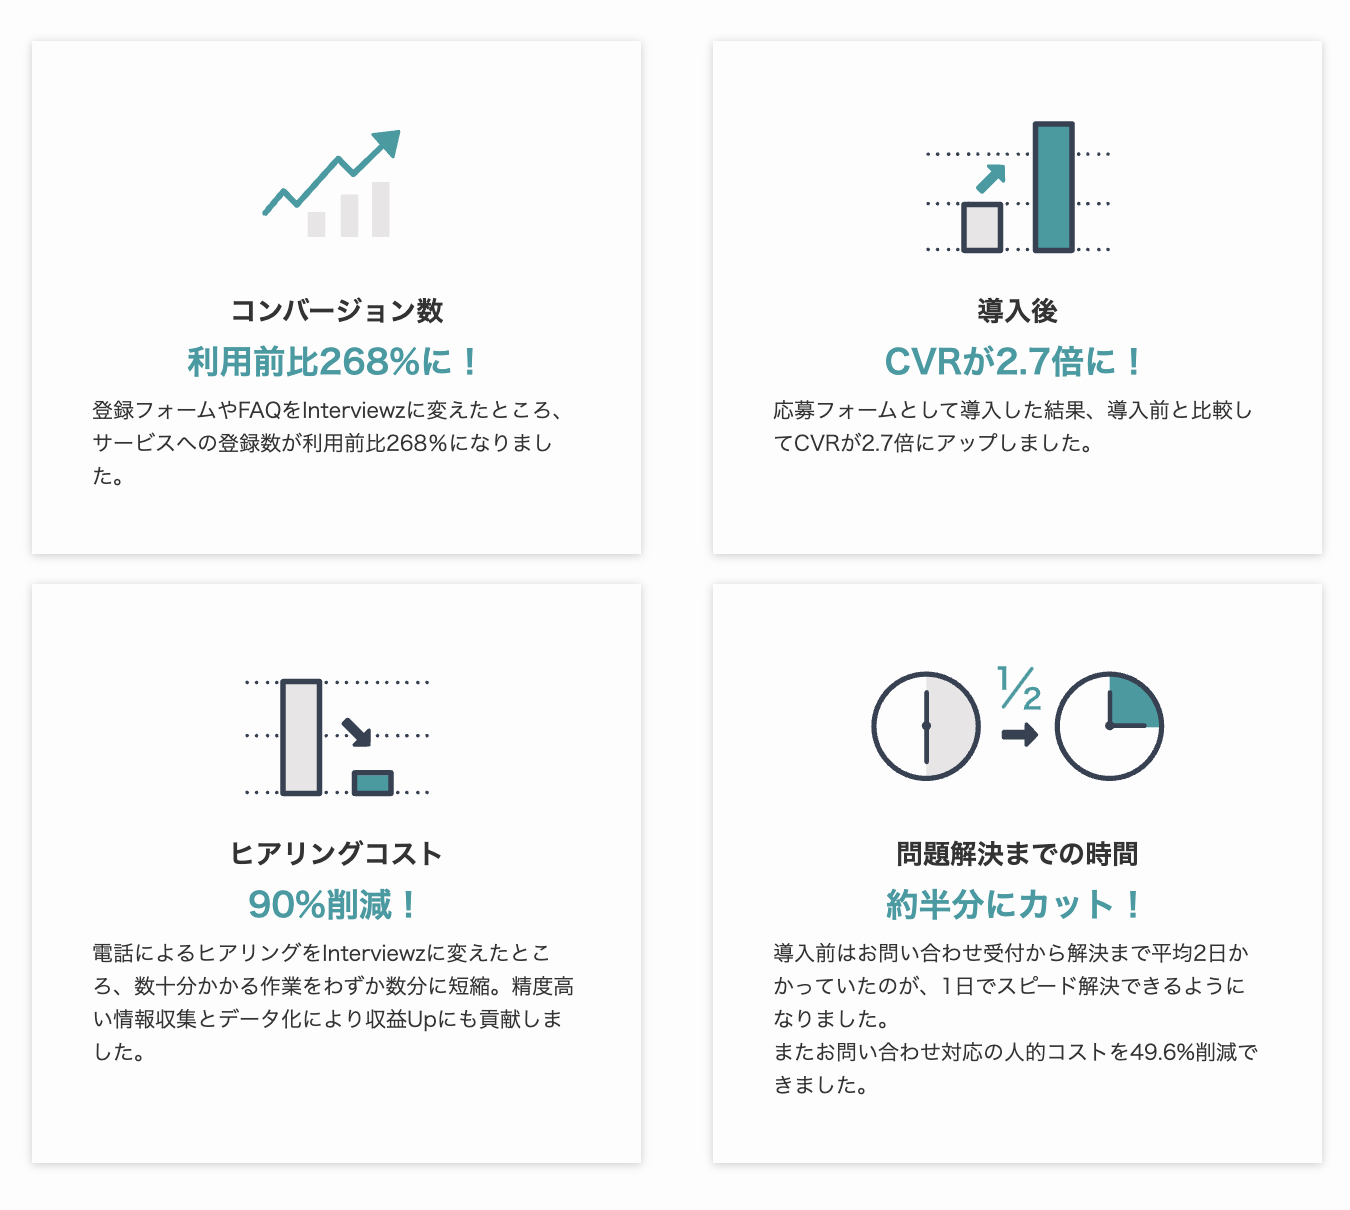
ヒアリングDXツール「Interviewz」を累計5,000社以上で提供。リード数268%向上・ヒアリングコスト90%削減・サポートコスト半減の実績をもとに、アンケート設計と統計分析の知見を発信しています。
ランダムサンプリングとは?無作為抽出の意味をわかりやすく解説
まずはランダムサンプリングの定義と、混同されやすい調査手法との違いを整理します。ここを曖昧なまま進めると、後工程のサンプルサイズ設計や分析がすべてずれてしまうため、最初に押さえておきましょう。
ランダムサンプリング(無作為抽出)の定義
ランダムサンプリングとは、母集団に含まれるすべての要素が「等しい確率」で選ばれるように標本(サンプル)を抽出する方法のことです。日本語では「無作為抽出」「ランダム抽出」と呼ばれ、統計学における確率抽出法(Probability Sampling)の代表格にあたります。
ポイントは「適当に選ぶ」ことではなく、「選ばれやすさに差がない状態を意図的につくる」という点にあります。担当者の判断で選びやすい人を選んでしまうと、そこには必ず主観的な偏りが混入します。
等確率で抽出されているからこそ、標本から母集団の平均や比率を統計的に推定でき、「誤差はプラスマイナス何ポイント」と数値で示せるようになります。これがランダムサンプリング最大の価値です。
全数調査(悉皆調査)との違い
全数調査は母集団に属する全員を調べる方法で、国勢調査が代表例です。理論上もっとも正確ですが、対象が数千人を超えると費用も期間も現実的でなくなります。
一方ランダムサンプリングは、母集団が1万人でも約370人の回答で、信頼水準95%・許容誤差5%の精度を確保できます。調査対象を4%未満に減らしても、実務判断には十分な精度が得られるのが大きな利点です。
ただし全数調査には「個別対応の起点になる」という別の価値もあります。従業員満足度調査のように全員に回答機会を提供すること自体が目的の一部である場合は、全数調査を選ぶ判断も合理的です。
| 比較項目 | ランダムサンプリング | 全数調査(悉皆調査) |
|---|---|---|
| 調査対象 | 母集団から抽出した一部 | 母集団の全員 |
| コスト | 低い(対象数に比例して削減) | 非常に高い |
| 調査期間 | 短い(数日〜数週間) | 長い(数週間〜数か月) |
| 結果の代表性 | 設計次第で高い(誤差は数値化可能) | 最も高い(標本誤差なし) |
| 集計・分析の負荷 | 軽い | 重い |
| 向いているケース | 市場調査・顧客満足度調査・品質検査 | 国勢調査・全社員向け調査・小規模母集団 |
有意抽出法(非確率サンプリング)との違い
有意抽出法は、調査者の判断や参加のしやすさで対象を選ぶ方法です。街頭調査、Web広告経由の応募、既存顧客への一斉配信などが該当し、「非確率サンプリング」とも呼ばれます。
手軽でスピーディーですが、選ばれる確率が人によって異なるため、統計的な誤差を計算できません。「回答者の70%が満足」という結果が出ても、それが母集団全体の傾向かどうかを保証できないのです。
探索的に仮説を出す段階では有意抽出でも十分ですが、経営判断や投資判断の根拠にする調査ではランダムサンプリングを選ぶべきだと言えます。目的に応じて使い分けましょう。
「サンプル数」と「サンプルサイズ」の違い【混同注意】
実務で最も多い誤用が、この2語の混同です。サンプルサイズ(n)は1つの標本に含まれる個体数を指し、300人にアンケートを配って300件回収したなら「サンプルサイズ300」となります。
対してサンプル数は標本そのものの個数で、「東日本と西日本で別々に300人ずつ調査した」なら、サンプル数は2、各サンプルサイズは300です。
調査会社に「サンプル数300でお願いします」と伝えると意図がずれる恐れがあります。社内外のコミュニケーションでは「回収数(サンプルサイズ)300件」と数量の単位まで明記すると誤解を防げます。
ランダムサンプリングが使われる代表的なシーン7選
ランダムサンプリングは学術研究だけのものではなく、ビジネスの意思決定の現場で日常的に使われています。代表的な7シーンを押さえておくと、自社での適用イメージが湧きやすくなります。
| シーン | 母集団の例 | 相性のよい手法 |
|---|---|---|
| 市場調査・ニーズ調査 | 特定カテゴリの購入者全体 | 層化抽出法 |
| 顧客満足度調査(CS/NPS) | 自社の全契約顧客 | 単純無作為抽出法 |
| テレビ視聴率調査 | 全国の世帯 | 多段抽出法 |
| 品質管理の抜き取り検査 | 製造ロット全体 | 系統抽出法 |
| 従業員エンゲージメント調査 | 全従業員 | 層化抽出法 |
| 教育・学術研究 | 対象学年の全生徒 | 集落抽出法 |
| Webログ・行動データ分析 | 全アクセスログ | 単純無作為抽出法 |
▼調査目的から逆算した質問設計を学びたい方はこちら
👉 ヒアリングシート作成ガイド(マーケティングリサーチ編)を無料でダウンロード
ランダムサンプリングの種類5つ比較一覧表|違いと使い分け
ランダムサンプリングには大きく5つの種類があり、母集団の性質・リストの有無・予算によって最適解が変わります。まずは一覧表で全体像をつかんでから、各手法の詳細を確認してください。
| 種類 | 抽出の考え方 | 精度 | コスト | 母集団リスト | 向いているケース |
|---|---|---|---|---|---|
| 単純無作為抽出法 | 全体から完全ランダムに抽出 | 高い | 中 | 全件必要 | 属性が均質で小〜中規模の母集団 |
| 層化抽出法 | 属性で層に分けて各層から抽出 | 最も高い | 中〜高 | 属性情報つきで必要 | 年代・地域・業種で差が出る調査 |
| 系統抽出法 | 一定間隔(k番目)で抽出 | 中〜高 | 低い | 並び順のあるリスト | 製造ラインの検査・伝票監査 |
| 集落抽出法 | 集落単位で選び中は全数調査 | 中 | 低い | 集落一覧のみでOK | 店舗・学校・事業所単位の調査 |
| 多段抽出法 | 段階を分けて絞り込む | 中〜高 | 低〜中 | 段階ごとの一覧 | 全国規模の大規模調査 |
単純無作為抽出法(シンプルランダムサンプリング)
母集団の全リストに通し番号を振り、乱数で必要件数を選ぶ最もシンプルで基本となる方法です。理論的な偏りが一切なく、統計的推定の前提をそのまま満たせます。
ただし、母集団全員分のリストが揃っていることが絶対条件です。10万人の顧客リストがあっても、メールアドレスが登録されているのが3万人だけなら、実質的にその3万人が母集団になってしまいます。
また、少数派の属性(例:全体の3%を占める特定業種)が偶然1件も選ばれない可能性があります。属性別の分析を行いたい場合は、後述の層化抽出法を選ぶほうが安全です。
層化抽出法(層別サンプリング)
母集団を年代・地域・業種・契約プランなどの属性で「層」に分け、各層から母集団の構成比に応じた数を抽出する方法です。日本語では層別サンプリング、層化無作為抽出とも呼ばれます。
最大のメリットは、同じサンプルサイズでも単純無作為抽出より標本誤差を小さくできる点にあります。層の内部が似た性質でまとまっているほど、この効果は大きくなります。
実務では「比例配分」と「均等配分」の使い分けが重要です。全体傾向を知りたいなら構成比どおりの比例配分、少数セグメントも同じ精度で比較したいなら各層同数の均等配分を選び、集計時にウェイトバックで補正します。
系統抽出法(等間隔サンプリング)
リストの先頭からランダムに1件目を決め、そこから一定間隔(k件おき)で機械的に抽出していく方法です。間隔kは「母集団サイズ ÷ 必要サンプルサイズ」で求めます。
1万件から370件を抽出するならk=27となり、乱数で決めた起点が5番目なら、5・32・59番目…と選んでいきます。乱数を1回しか使わないため、現場のオペレーションが非常に軽いのが強みです。
注意点は「周期性の罠」です。リストが「男女交互」「7日周期」など規則的に並んでいると、抽出結果が特定属性に偏ります。実施前に必ず並び順を確認し、必要ならリストをシャッフルしてから適用してください。
集落抽出法(クラスターサンプリング)
母集団を店舗・学校・事業所といった自然なまとまり(クラスター)に分け、そのクラスターをランダムに選び、選ばれた中は全員を調査する方法です。
全国200店舗から20店舗を無作為に選び、その20店舗の来店客全員に調査する、といった使い方をします。個人単位のリストが不要で、訪問・配布コストを劇的に下げられるのが最大の利点です。
一方で、同じクラスター内の人は性質が似ているため(都心店と郊外店では客層が異なるなど)、同じサンプルサイズでも誤差は大きくなりがちです。選ぶクラスター数をできるだけ増やすことで精度を補えます。
多段抽出法(マルチステージサンプリング)
抽出を複数の段階に分ける方法で、「都道府県を選ぶ→市区町村を選ぶ→世帯を選ぶ」のように絞り込んでいきます。テレビ視聴率調査や大規模な世論調査で標準的に使われています。
全国民のリストがなくても、段階ごとの一覧(自治体一覧など)さえあれば実施できる点が実務上の強みです。調査エリアが集約されるため、訪問調査の移動コストも抑えられます。
ただし段階が増えるほど誤差が積み上がるため、各段階の抽出確率を記録し、集計時に抽出確率の逆数でウェイトをかける処理が欠かせません。設計と集計に統計知識が必要な、上級者向けの手法です。
ランダムサンプリング調査の質問項目一覧表

抽出方法が決まったら、次は質問票の設計です。ランダムサンプリング調査では「本設問」だけでなく、抽出の妥当性を検証するための設問を必ず組み込む必要があります。
以下は、実務でそのまま流用できる質問項目の一覧です。属性設問とウェイトバック用設問を落とすと、後から代表性を検証できなくなるため注意してください。
| 設問区分 | 質問項目例 | 目的 | 回答形式 |
|---|---|---|---|
| スクリーニング | 直近6か月以内に該当カテゴリの商品を購入しましたか | 調査対象外を除外する | 単一選択 |
| スクリーニング | あなたご自身または同居のご家族に、調査業・広告業の方はいますか | 利害関係者を除外する | 単一選択 |
| 属性(デモグラ) | 性別/年代/お住まいの都道府県 | 母集団構成比との照合 | 単一選択 |
| 属性(BtoB) | 業種/従業員規模/役職/担当領域 | 層別クロス集計の軸 | 単一選択 |
| 本設問(実態) | 現在利用しているサービスをすべてお選びください | 利用実態の把握 | 複数選択 |
| 本設問(評価) | 総合的な満足度を5段階でお答えください | 満足度スコアの算出 | 5段階尺度 |
| 本設問(推奨度) | 知人に薦める可能性を0〜10でお答えください | NPSの算出 | 11段階尺度 |
| 本設問(自由回答) | その評価をつけた理由をお聞かせください | 定性的な理由の深掘り | 自由記述 |
| ウェイトバック用 | 世帯年収/職業/同居人数 | 母集団構成比への補正 | 単一選択 |
| 品質チェック | この設問では「3」を選んでください | 不誠実回答(サティスファイス)の検出 | 単一選択 |
| クロージング | 追加調査へのご協力は可能ですか | デプスインタビューへの誘導 | 単一選択 |
▼設問設計をゼロから作る手間を省きたい方はこちら
👉 ヒアリングシート/アンケートテンプレート集を無料で入手する
ランダムサンプリングのやり方7ステップ
ここからは、実際にランダムサンプリングを実施する手順を7ステップで解説します。ExcelとGoogleスプレッドシート、Pythonそれぞれの具体的なコード・関数まで示すので、そのまま業務に落とし込めます。
STEP1|調査目的とリサーチクエスチョンを定義する
最初に決めるべきは「この調査で何を意思決定するのか」です。「顧客満足度を知りたい」ではなく「解約率の高いプランを特定し、次期の改善投資先を決める」まで具体化します。
目的が定まると、必要な精度(許容誤差)と分析軸(層)が自動的に決まります。逆に目的が曖昧なまま設問を作ると、設問数だけが膨らみ、回答途中の離脱率が跳ね上がります。
実務では「調査結果がAだったら何をするか/Bだったら何をするか」を先に紙に書き出すのが有効です。どちらの結果でも打ち手が同じなら、その設問は不要と判断できます。
STEP2|母集団と抽出枠(サンプリングフレーム)を確定する
母集団とは「結論を当てはめたい対象全体」、抽出枠(サンプリングフレーム)とは「実際に手元にある名簿」のことです。この2つのズレがカバレッジ誤差と呼ばれ、あらゆる調査で最大の誤差要因になります。
たとえば母集団が「全国の20代会社員」なのに、抽出枠が「自社メルマガ会員」であれば、その時点で結果は自社に関心のある層に偏ります。抽出枠が母集団の何%をカバーしているかを、数値で把握しておくことが重要です。
カバーできない層がある場合は、外部のリサーチパネルを併用する、あるいはレポートに「本調査の母集団は自社会員に限定される」と明記するという誠実な対処を取りましょう。
STEP3|サンプルサイズを計算する
ランダムサンプリングで最も質問が多いのがこの工程です。感覚で「とりあえず100件」と決めるのではなく、計算式に基づいて必要数を求めます。
サンプルサイズの計算式
母集団が十分に大きい場合の基本式は次のとおりです。
n = z² × p × (1 − p) ÷ d²
ここでnは必要サンプルサイズ、zは信頼水準に対応する値(95%なら1.96、99%なら2.576)、pは想定される回答比率(不明なら最も厳しい0.5)、dは許容誤差(5%なら0.05)です。
信頼水準95%・許容誤差5%・p=0.5を代入すると、n = 1.96² × 0.5 × 0.5 ÷ 0.05² = 約385件となります。母集団が有限の場合は、次の補正式を使います。
n = N × z²p(1−p) ÷ { d²(N−1) + z²p(1−p) }(Nは母集団サイズ)
母集団規模別の必要サンプルサイズ早見表
毎回計算するのは煩雑なので、信頼水準95%における母集団規模×許容誤差の早見表を用意しました。実務ではこの表を参照すれば十分です。
| 母集団サイズ | 許容誤差3% | 許容誤差5% | 許容誤差10% |
|---|---|---|---|
| 100 | 92 | 80 | 50 |
| 500 | 341 | 218 | 81 |
| 1,000 | 517 | 278 | 88 |
| 5,000 | 880 | 357 | 95 |
| 10,000 | 965 | 370 | 96 |
| 50,000 | 1,045 | 382 | 96 |
| 100,000 | 1,056 | 383 | 96 |
| 1,000,000 | 1,066 | 384 | 97 |
表を見ると、母集団が1万を超えると必要サンプルサイズはほとんど増えないことがわかります。100万人が対象でも384件で足りるという事実は、調査予算を検討するうえで極めて重要です。
信頼水準と許容誤差の決め方
信頼水準は「同じ調査を100回繰り返したとき、何回が真の値を含む範囲に収まるか」を示します。ビジネス調査の標準は95%で、医薬品開発や安全性検証など失敗が許されない領域では99%を採用します。
許容誤差は「結果が何ポイントずれても許容できるか」です。大まかな傾向把握なら10%、通常の意思決定なら5%、僅差の比較や値付けの判断なら3%が目安になります。
信頼水準を95%から99%に上げると必要数は約1.7倍、許容誤差を5%から3%に下げると約2.8倍に増えます。精度を上げるほどコストは非線形に増えるため、目的に照らして過剰な精度を求めないことが実務的です。
回収率から配信数を逆算する
見落とされがちですが、必要なのは「配信数」ではなく「回収数」です。必要回収数 ÷ 想定回答率 = 必要配信数、で逆算します。
回収数370件が必要で、メール調査の想定回答率が15%なら、370 ÷ 0.15 = 約2,467件への配信が必要です。ここを見誤ると調査期間の終盤で慌てて追加配信することになります。
一般的な回答率の目安は、社内アンケートで50〜80%、既存顧客へのメール調査で10〜20%、コールドリストへの配信で2〜5%程度です。初回は少し多めに配信し、実測値を次回の設計に反映させる運用が確実です。
STEP4|サンプリング手法を選ぶ
ここまでの情報が揃えば、手法は次の3つの問いでほぼ決まります。迷ったときはこのフローで判断してください。
- 母集団全員のリストがあるか? → ない場合は集落抽出法または多段抽出法へ。
- 属性別に結果を比較したいか? → 比較したいなら層化抽出法へ。
- リストに規則的な並び順があるか? → 規則性がなく運用を簡略化したいなら系統抽出法、それ以外は単純無作為抽出法へ。
STEP5|Excelでランダム抽出を実行する
Excelでの実施方法は主に3つあります。最も汎用的で失敗が少ないのがRAND関数を使う方法です。
方法1:RAND関数+並べ替え――リストの隣の列に「=RAND()」を入力して全行にコピーし、その列を昇順で並べ替えて上位n件を採用します。3ステップで完了する最短手順です。
方法2:分析ツールのサンプリング機能――[データ]タブ→[データ分析]→[サンプリング]を選択します。ただし数値データしか扱えず、標本数を指定すると重複抽出(復元抽出)になる点に注意が必要です。
方法3:新しい関数を使う――Microsoft 365環境なら「=SORTBY(A2:D1001, RANDARRAY(1000))」の1式でリスト全体をランダム並べ替えでき、上からn行を取るだけで抽出が完了します。
いずれの方法でもRAND関数は再計算のたびに値が変わる揮発性関数です。並べ替えたら必ず「値として貼り付け」で固定してください。これを怠ると、翌日開いたときに抽出結果が変わり、再現性を失います。
STEP6|スプレッドシート・Pythonで抽出する
Googleスプレッドシートでも考え方は同じで、「=RAND()」または「=RANDBETWEEN(1,1000)」で乱数列を作り、フィルタで並べ替えます。複数人で同時編集する場合は、抽出後すぐに別シートへ値貼り付けするのが安全です。
データ量が数万件を超えるならPythonが圧倒的に高速です。pandasを使えば「df.sample(n=370, random_state=42)」の1行で単純無作為抽出が完了します。
層化抽出も「df.groupby(‘業種’).apply(lambda x: x.sample(frac=0.05, random_state=42))」で実行できます。random_state(シード値)を指定しておけば、いつ実行しても同じ結果を再現できるため、監査対応が必要な調査では必須の作法です。
STEP7|抽出結果の代表性を検証する
抽出したら終わりではありません。抽出後のサンプルの属性構成比が、母集団の構成比とどれだけ一致しているかを必ず確認します。
具体的には、性別・年代・地域・業種などの主要属性について、母集団とサンプルの比率を並べた表を作ります。差が5ポイント以上ある属性が見つかったら、追加抽出かウェイトバック集計での補正を検討してください。
より厳密に検証したい場合は、カイ二乗適合度検定を用いて「サンプルの構成比は母集団と有意に異なるか」を統計的に判定します。この検証結果をレポートに1枚添えるだけで、調査の信頼性は大きく高まります。
▼調査設計に強いアンケートツールの選定基準を知りたい方はこちら
👉 アンケートツール選び方ガイドを無料でダウンロード
ランダムサンプリングの精度を高めるコツ8選
ランダムサンプリングは「正しく抽出したつもり」で失敗するケースが非常に多い手法です。ここでは調査の現場で実際に効果があった8つのコツを、判断基準と具体例つきで解説します。
コツ1|抽出枠のカバレッジ誤差をつぶす
どれだけ完璧に乱数を回しても、元のリストが母集団を代表していなければ結果は必ず歪みます。これがカバレッジ誤差であり、実務における最大の失敗要因です。
チェック方法はシンプルで、抽出枠に含まれる件数を母集団の推定規模で割り、カバー率を出します。カバー率が70%を下回る場合は、その調査結果を「母集団全体の傾向」として語らないのが原則です。
改善策としては、休眠顧客リストの名寄せ、紙台帳のデジタル化、外部パネルの併用などがあります。調査を始める前の1週間をリスト整備に使うほうが、回収後に補正で苦労するより確実です。
コツ2|層化で属性の偏りを事前に防ぐ
単純無作為抽出は理論上は偏りませんが、1回きりの抽出では偶然の偏りが起こります。特にサンプルサイズが300件前後だと、少数属性が数件しか入らないことは珍しくありません。
これを防ぐのが層化です。分析軸として使う予定の属性(年代・業種・契約プランなど)を層に設定し、各層の回収数が最低30件を下回らないように配分してください。30件は統計的な比較を行うための実務的な下限です。
層は多くしすぎないことも重要です。層の数は3〜5程度に絞り、掛け合わせるとしても2軸までにとどめると、必要サンプルサイズが現実的な範囲に収まります。
コツ3|乱数のシード値を記録して再現性を確保する
ExcelのRAND関数もPythonのrandomも、実際には計算によって作られる擬似乱数です。シード値(起点となる数値)を指定すれば、何度実行しても同じ結果を再現できます。
Pythonなら「random_state=42」のように引数で指定し、その値を調査仕様書に記録します。Excelの場合はシード指定ができないため、抽出直後に値貼り付けし、抽出リストそのものを証跡として保存してください。
この一手間が効いてくるのは、監査対応や社内での再検証の場面です。「なぜこの300社が選ばれたのか」を後から説明できる状態にしておくことが、調査結果の説得力を支えます。
コツ4|回収率から逆算して配信数を決める
必要サンプルサイズを「配信数」と取り違えると、調査終盤で回収数が足りない事態に陥ります。必要回収数 ÷ 想定回答率 = 配信数という逆算を必ず行いましょう。
加えて、回収したデータのうち5〜15%は不良回答として除外されることも見込む必要があります。全設問で同じ選択肢を選ぶ直線回答や、極端に短い回答時間のデータは分析から除くべきだからです。
実務では「必要回収数 × 1.2 ÷ 想定回答率」を配信数の目安にすると、大きく外しません。初回調査の実測回答率を記録し、2回目以降の精度を上げていく運用が理想的です。
コツ5|無回答バイアスを回答者属性で検証する
ランダムに配信しても、回答してくれる人には偏りがあります。満足度が極端に高い人と低い人は回答しやすく、無関心層は回答しない――これが無回答バイアス(ノンレスポンスバイアス)です。
検証方法として有効なのが「早期回答者と後期回答者の比較」です。配信直後に回答した層と、リマインド後に回答した層でスコアに差があるなら、未回答者はさらに違う傾向を持つ可能性が高いと推測できます。
差が大きい場合は、リマインドを追加して回収率そのものを引き上げるのが最も確実な対処です。回収率が50%を超えると無回答バイアスの影響は大きく減衰するとされています。
コツ6|ウェイトバック集計で母集団構成に補正する
回収データの属性構成が母集団とずれてしまった場合、各回答に重み(ウェイト)をかけて構成比を母集団に合わせるのがウェイトバック集計です。
計算式はウェイト値 = 母集団の構成比 ÷ 回収サンプルの構成比。母集団の30代比率が25%なのに回収が20%だったなら、30代の回答に1.25の重みをかけて集計します。
ただし補正は万能ではありません。ウェイト値が3倍を超えるような極端な補正は、少数の回答が結果を左右してしまうため危険です。その場合は追加回収を優先してください。
コツ7|スクリーニング設問で対象外を除外する
抽出が正しくても、回答者が本当に調査対象なのかを確認しなければ、データの質は担保できません。冒頭にスクリーニング設問を置き、条件に合わない回答者を丁寧に離脱させます。
BtoB調査なら「該当業務の決裁・検討に関与しているか」、購買調査なら「直近6か月の購入経験」が典型です。謝礼目当ての虚偽回答を防ぐため、選択肢にはダミーの商品名やサービス名を混ぜるのが定石です。
また、調査業・広告業・競合企業の関係者を除外する設問も入れておきましょう。この1問があるだけで、情報漏えいリスクとデータ汚染を同時に抑えられます。
コツ8|インセンティブ設計で回答率を底上げする
無回答バイアスへの最善の対処は、そもそも回収率を上げることです。そのために効果が大きいのがインセンティブ設計と、回答負荷の削減です。
設問数は10問以内・所要時間3分以内が目安で、スマートフォンで1画面1問ずつ進むUIにするだけで完了率は大きく改善します。進捗バーの表示も離脱防止に有効です。
謝礼はデジタルギフトが実務的に扱いやすく、即時配布できるため回答直後の満足度も高まります。抽選方式より全員配布の少額ギフトのほうが、回答率は安定して伸びる傾向があります。
▼回答率を高める設計ノウハウをまとめて確認したい方はこちら
👉 ユーザーからの回答率の高いアンケートの作り方【6つのコツ】を無料でダウンロード

▼謝礼設計から回収率を改善したい方はこちら
👉 Interviewzのデジタルギフト付きアンケート資料を無料で見る
ランダムサンプリングのメリット5つ
ランダムサンプリングを採用する価値は、単に「楽だから」ではありません。他の手法では代替できない5つの本質的なメリットを整理します。
メリット1|母集団の縮図を再現でき代表性が高い
すべての要素が等しい確率で選ばれるため、抽出されたサンプルは母集団の縮図に近づきます。年代・地域・購買頻度といった、事前に把握していない属性についても自動的に近い構成になる点が強みです。
層化やクォータ抽出では「指定した属性」しか合わせられませんが、ランダムサンプリングは未知の変数についても偏りが期待値ゼロになるという理論的な保証を持ちます。これが学術研究で標準的に用いられる理由です。
メリット2|調査コストと期間を大幅に削減できる
母集団が10万人でも、必要な回答は約383件で済みます。調査対象を0.4%まで圧縮できるため、費用も期間も桁違いに軽くなります。
外部パネルを使う場合の費用は1回答あたり数百円が相場で、400件なら十数万円規模。全数調査に比べれば、意思決定のスピードとコストの両面で圧倒的に有利です。
メリット3|誤差の大きさを数値で示せる
ランダムサンプリング最大の実務価値が、「この結果はプラスマイナス何ポイントの範囲にある」と定量的に説明できることです。有意抽出法ではこれができません。
「満足度62%(n=385、95%信頼区間 ±5.0pt)」と示せば、経営会議で「57〜67%の範囲に真の値がある」という共通認識を作れます。数字の解釈をめぐる不毛な議論を防げる点は非常に大きい利点です。
メリット4|恣意的な選定バイアスを排除できる
担当者が対象を選ぶと、無意識に「話を聞きやすい顧客」「関係の良い取引先」に偏ります。結果として実態より良い数字が出てしまい、課題が見えなくなるのが典型的な失敗です。
乱数によって機械的に選ぶことで、この主観を構造的に排除できます。「都合の悪い顧客も等しく選ばれる」ことが、調査を意思決定に使える情報に変えるのです。
メリット5|統計的検定・推定の前提を満たせる
t検定、カイ二乗検定、回帰分析といった統計手法は、いずれもデータが無作為抽出されていることを前提としています。前提を満たさないデータに検定をかけても、出てきたp値には意味がありません。
ランダムサンプリングで得たデータであれば、「A群とB群の差は誤差の範囲か、それとも本物か」を統計的に判定できます。施策のA/Bテストや効果測定を正しく行うための土台になります。
ランダムサンプリングのデメリット5つと回避策
万能に見えるランダムサンプリングにも、明確な弱点があります。デメリットを知ったうえで回避策とセットで運用することが、調査の成否を分けます。
デメリット1|標本誤差はゼロにならない
一部だけを調べる以上、標本誤差は原理的に必ず発生します。サンプルサイズを増やせば小さくできますが、誤差は「サンプルサイズの平方根」に反比例するため、精度を2倍にするには4倍の回答が必要です。
回避策:誤差をゼロにしようとせず、意思決定に必要な精度を先に決めることです。「10ポイント以上の差があれば施策を切り替える」といった判断基準を先に置けば、許容誤差5%で十分と割り切れます。
デメリット2|母集団リストがないと実施できない
単純無作為抽出も系統抽出も、母集団の一覧がなければ実行できません。BtoB調査で「国内の中小製造業すべて」を母集団にしたい場合、その完全なリストは通常入手できません。
回避策:リストが手に入る単位まで母集団を分解し、集落抽出法や多段抽出法に切り替えることです。または調査会社のパネルを利用し、母集団に近い構成で割付を行う方法もあります。
デメリット3|少数派の意見が拾えないことがある
全体の2%しかいないセグメントは、385件抽出しても期待値で8件程度しか含まれません。この件数では、そのセグメント単独の傾向を語ることはできません。
回避策:層化抽出法で該当セグメントを1つの層とし、意図的に多めに(最低30件以上)割り付けることです。全体集計する際は、ウェイトバックで元の構成比に戻して整合を取ります。
デメリット4|無回答バイアスで結果が歪む
抽出は無作為でも、回答するかどうかは対象者が決めます。関心の高い層ほど回答しやすいため、回収データは母集団より「熱量の高い集団」に寄りがちです。
回避策:リマインド送付で回収率を高めること、そして回答者と未回答者の属性構成を比較して差を確認することです。差が確認された場合は、レポートにその旨を必ず明記します。
デメリット5|設計・実施に専門知識と工数がかかる
サンプルサイズの計算、層の設計、ウェイトバック処理、検定――いずれも一定の統計知識を要します。片手間で進めると、抽出は正しくても分析で誤った結論を出すリスクがあります。
回避策:サンプルサイズ計算や集計を自動化するツールを使い、担当者は「目的設定」と「解釈」に集中することです。属性設問と本設問のクロス集計まで自動化できるツールを選べば、工数は大幅に減らせます。
ランダムサンプリング結果の分析・活用方法
データが集まったら、いよいよ分析です。ランダムサンプリングならではの「誤差を踏まえた読み方」を押さえておくと、結論の精度が一段上がります。
単純集計(GT)で全体傾向をつかむ
まずは全設問について、選択肢ごとの回答数と構成比を出す単純集計(GT表)を作ります。ここで想定と大きく違う結果が出た設問こそが、深掘りすべき論点です。
この段階で必ず有効回答数(n)を明記してください。設問によって回答者数が異なる場合、分母がずれたまま比較して誤った結論を出す事故が頻発します。
クロス集計で属性差を可視化する
次に、属性設問を軸にしたクロス集計を行います。「全体では60%が満足だが、契約1年未満では40%にとどまる」といった差が見えてはじめて、打つべき施策が特定できます。
注意点は、セルのnが30件を下回る区分は参考値として扱うことです。少数のセルで生じた差は、ほとんどが誤差の範囲に収まります。
信頼区間で「差」が誤差の範囲かを判断する
比率の信頼区間はp ± 1.96 × √{ p(1−p) ÷ n } で概算できます。n=385、p=0.6なら誤差は約±4.9ポイントです。
この幅を知っていれば、「今期62%、前期60%」という2ポイントの差が、実際には誤差の範囲内であると冷静に判断できます。誤差を無視した過剰解釈は、調査で最も多い失敗です。
t検定・カイ二乗検定で有意差を確かめる
2群の平均値を比べるならt検定、選択肢の分布を比べるならカイ二乗検定を使います。Excelの分析ツールでも数クリックで実行でき、p値が0.05未満なら「統計的に有意な差」と判断します。
ただしサンプルサイズが大きいと、実務上は無視できる小さな差でも有意になります。p値だけでなく「差の大きさ(効果量)」を必ずセットで確認してください。
レポーティングで「n数と誤差」を必ず明記する
報告書には、調査方法・母集団・抽出方法・有効回答数・調査期間を明記した調査概要ページを冒頭に1枚入れるのが標準です。これがあるだけで、レポートの信頼性は格段に上がります。
グラフには必ず(n=385)を添え、誤差を超えない差については「同程度」と表現することを徹底しましょう。誠実な表現は、結果として結論への納得感を高めます。
▼調査結果を社内で通るレポートにまとめたい方はこちら
👉 ヒアリング&診断コンテンツの実例集を無料でダウンロード
ランダムサンプリングの実践事例3選
ここでは、実務でランダムサンプリングがどう使われるかを3つの具体的なシナリオで紹介します。手法選定の考え方の参考にしてください。
事例1|BtoB SaaSの解約要因調査(層化抽出法)
契約社数8,000社のSaaS事業者が、解約率の高いセグメントを特定するために実施したケースです。母集団を「契約年数(1年未満/1〜3年/3年以上)」で3層に分け、各層から均等に130件ずつ抽出しました。
単純無作為抽出では契約3年以上の層が全体の1割しかなく比較に足る件数を確保できませんでしたが、均等配分の層化により全層で有意差の検定が可能になりました。全体傾向を出す際はウェイトバックで構成比を戻しています。
結果として、契約1年未満の層で「初期設定の難しさ」が突出していることが判明。オンボーディング支援に投資先を絞る意思決定につながったのがこの調査の成果です。
事例2|製造業における抜き取り検査(系統抽出法)
1日あたり12,000個を生産するラインで、全数検査が不可能なため抜き取り検査を導入したケースです。必要サンプルサイズ370個を確保するため、間隔k=32として32個ごとに1個を抽出しました。
導入前に確認したのが並び順の周期性です。4台の成形機から順番に製品が流れる構造だったため、k=32では特定の1台に偏るリスクがありました。そこでkを素数の31に変更し、周期性の重複を回避しています。
この調整により、4台すべての機械からほぼ均等にサンプルが抽出される状態を実現。特定機械に起因する不良の早期発見が可能になりました。
事例3|小売チェーンの顧客満足度調査(多段抽出法)
全国240店舗を展開する小売チェーンが、顧客リストを持たない状態で満足度調査を行ったケースです。まずエリアを無作為に8つ選び、次に各エリアから3店舗ずつ計24店舗を抽出しました。
選ばれた24店舗で、来店客に対しレシートのQRコードからWebアンケートへ誘導する方式を採用。個人リストが一切なくても、確率抽出に近い設計が実現できる点が多段抽出法の強みです。
集計時には、エリアの選択確率と店舗の選択確率の逆数をウェイトとして適用し、全社の数値として推定しました。デジタルギフトを謝礼にしたことで、回答率は従来の紙アンケートの約3倍に向上しています。
▼調査に使えるヒアリングツールを比較検討したい方はこちら
👉 ヒアリングツール10選の比較資料を無料でダウンロード

ランダムサンプリング調査を効率化するなら「Interviewz(インタビューズ)」がおすすめ!
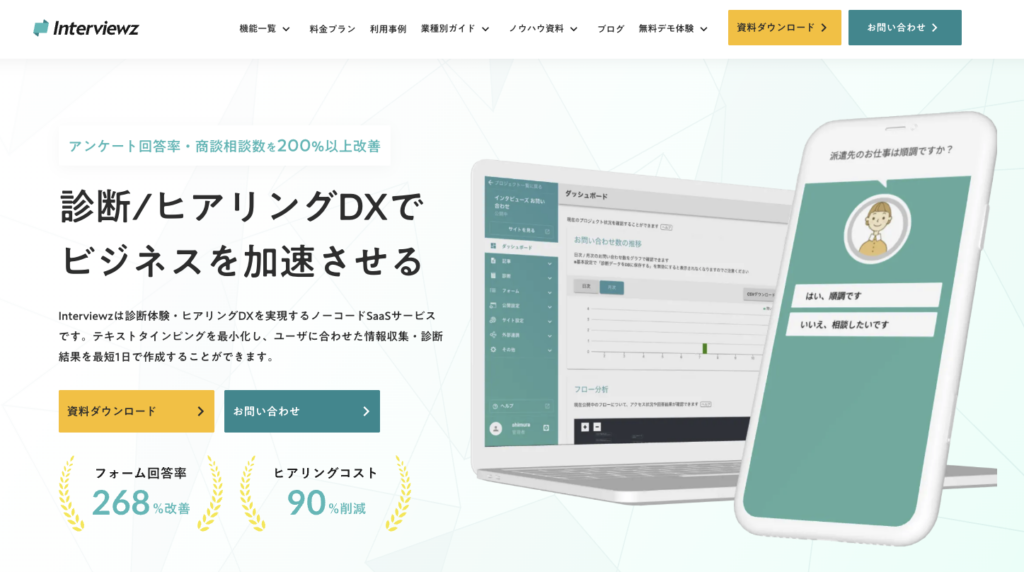
ランダムサンプリングは、抽出そのものより「回収率の確保」と「集計・分析の工数」がボトルネックになります。ここを解決するのがヒアリングDXツール「Interviewz(インタビューズ)」です。
Interviewz(インタビューズ)とは
Interviewzは、タップ操作中心のチャット型UIでアンケート・ヒアリングを実施できるツールです。プログラミング不要で設問を作成でき、回答データはリアルタイムで自動集計されます。
アンケート、顧客ヒアリング、診断コンテンツ、社内調査までを1つの管理画面で運用でき、SalesforceやHubSpotなどの外部ツール連携にも対応しています。
ランダムサンプリング調査にInterviewzが向いている5つの理由
数あるアンケートツールのなかで、Interviewzが確率抽出型の調査と相性がよい理由を5つに分けて説明します。
理由1|タップ型UIで回答率が上がり無回答バイアスを抑えられる
ランダムサンプリングの精度を最も脅かすのは無回答バイアスです。Interviewzは1画面1問のタップ形式で、スマートフォンでも数十秒で回答が完了する設計になっています。
回答負荷が下がれば回収率が上がり、結果として未回答層との差=バイアスが縮小します。これは統計的な精度に直結する効果です。
理由2|分岐ロジックでスクリーニング設問を自動制御できる
条件分岐を設定すれば、スクリーニング設問で対象外と判定された回答者を自動的に終了画面へ遷移させられます。手作業での除外処理が不要になります。
属性に応じて出し分ける設問も設定できるため、層別に異なる深掘り質問を投げるといった高度な設計も可能です。
理由3|属性別クロス集計が自動化され分析工数を削減できる
回答データは管理画面上で自動集計され、属性軸でのクロス集計もその場で確認できます。CSVエクスポートしてExcelで組み直す手間がかかりません。
層化抽出の結果を層ごとに比較する作業がワンクリックで済むため、分析リードタイムを大幅に短縮できます。
理由4|デジタルギフト連携で謝礼配布まで完結する
回答完了後にデジタルギフトを自動配布する機能を備えています。謝礼の手配・発送という運用負荷をゼロにしながら、回答率を底上げできるのが実務上の大きな利点です。
即時配布されるため回答体験の満足度も高く、継続的なパネル調査での再協力率向上にもつながります。
理由5|導入企業でリード数268%向上・コスト90%削減の実績がある
Interviewzを導入した企業では、ヒアリング経由のリード数が268%向上、調査・ヒアリングにかかるコストが90%削減された実績があります。
調査を「コストセンター」から「リード獲得の起点」に転換できる点が、マーケティング部門で評価されている理由です。
Interviewzの導入効果と料金
初期費用を抑えたスモールスタートが可能で、無料トライアルで実際の設問作成と集計画面を試せます。導入時には設問設計の相談にも対応しています。
▼実際の画面と操作感を試したい方はこちら
👉 Interviewzの無料ヒアリングデモを体験する
▼機能・料金をまとめて確認したい方はこちら
👉 インタビューズ サービス概要資料を無料でダウンロード

よくある質問(FAQ)
Q1. サンプルサイズは結局いくつにすればよいですか?
A. 信頼水準95%・許容誤差5%で設計するなら、母集団が1万人以上でも約385件が目安です。母集団が1,000人なら278件、100人なら80件で足ります。
属性別に比較したい場合は、比較したいセグメントごとに最低30件、できれば100件を確保できるようサンプルサイズを積み上げてください。
Q2. 単純無作為抽出と層化抽出はどちらを選ぶべきですか?
A. 属性別に結果を比較する予定があるなら層化抽出、全体傾向だけを知りたいなら単純無作為抽出が基本です。
迷ったときは層化抽出を選んでおくと安全です。同じサンプルサイズで誤差を小さくできるうえ、比例配分にすれば全体集計もそのまま行えます。
Q3. 母集団リストがない場合はどうすればよいですか?
A. リストが入手できる単位まで母集団を分解し、集落抽出法や多段抽出法に切り替えます。店舗一覧や事業所一覧など、まとまり単位のリストなら入手できるケースが多いためです。
それも難しければ、調査会社のリサーチパネルを利用し、母集団の構成比に合わせて割付(クォータ)を行う方法が現実的な代替になります。
Q4. Excelのランダム抽出で気をつけることは?
A. RAND関数は再計算のたびに値が変わる揮発性関数なので、並べ替え後に必ず「値として貼り付け」で固定してください。固定しないと抽出結果を再現できません。
また、分析ツールの[サンプリング]機能は数値データのみ対応で、標本数指定では重複抽出になる点にも注意が必要です。氏名や社名を含むリストではRAND関数方式を使いましょう。
Q5. ランダムサンプリングと全数調査はどちらが正確ですか?
A. 理論上は全数調査が最も正確ですが、実務では必ずしもそうとは限りません。全数調査は回収に時間がかかり、未回収分の偏りや入力ミスが積み上がりやすいためです。
回収率を高く保てる規模ならランダムサンプリングのほうが速く・安く・十分な精度で結論を出せるケースが多いと言えます。
Q6. 回答に偏りが出てしまった場合はどう対処しますか?
A. まずは追加回収で偏りそのものを減らすのが第一選択です。それが難しい場合は、ウェイトバック集計で母集団の構成比に補正します。
ただしウェイト値が3倍を超える極端な補正は、少数の回答が結果を左右してしまうため推奨できません。その場合はレポートに制約条件として明記しましょう。
あわせて読みたい関連記事
調査設計・統計の基礎(直接的な関連)
- 標本調査とは?全数調査との違い・メリット・デメリット・種類7選を徹底解説
- アンケート調査に影響するバイアス6つと回答精度を高める質問設計の方法を解説
- t検定をエクセルで行う方法7ステップ|関数と分析ツールを図解
アンケート設計・作成
- アンケート項目の作り方を徹底解説|目的別・質問例・作成のコツも紹介
- アンケートの設問設計の手順と失敗しない作り方のコツをわかりやすく解説
- アンケート設計のコツと注意点|成功事例と失敗事例を比較して解説
- アンケートの作り方と回答率の高い質問事例をテンプレ付きで解説
- 社内アンケートの作り方|本音を引き出す質問のコツと注意点を徹底解説【テンプレート付き】
分析・調査レポート
- アンケートの分析方法4ステップで解説|分析のコツから活用方法まで
- アンケートの分析方法8選と分析の質を高める方法を徹底解説
- クロス集計をエクセルで効率化|アンケート分析の手順とコツを徹底解説
- アンケートレポート(調査報告書)の書き方とビジネスに活かすコツを解説
- ヒアリング・アンケート結果をパワポで作成する方法|調査報告書の作り方とテンプレート
ヒアリング・営業活用
顧客満足度・CX
回答率向上・インセンティブ
- アンケート回答率を上げる方法12選|平均・計算式・設計のコツを徹底解説
- アンケートのお願い文の書き方9選|回答率が上がる例文・テンプレート完全ガイド
- アンケートの謝礼やプレゼントの送り方|種類と相場、注意点を徹底解説
- アンケートのプレゼントにデジタルギフトがおすすめな理由|選び方や注意点も解説
診断コンテンツ・ナーチャリング
情報収集・周辺ツール
- ネットリサーチおすすめツール20選と選び方、調査を効率化する方法を徹底解説
- アンケート調査会社おすすめ15社を徹底比較|失敗しない選び方と費用相場も徹底解説
- アンケートサイト15選|情報収集・市場調査に使えるサイトを取れるデータごとに解説
- Googleフォームで作成するアンケート結果の集計と活用の方法を解説
- クラウドソーシングでアンケート調査|メリット7選と費用・注意点を徹底解説
まとめ|目的と母集団に合わせて使い分け、誤差を数値で語ろう
ランダムサンプリングは、少ないコストで母集団の実像を捉え、その確からしさを数値で示せる唯一の調査アプローチです。本記事の要点を整理します。
- 定義:母集団の全要素が等しい確率で選ばれる抽出法。「適当に選ぶ」ではなく「選ばれやすさに差をつくらない」ことが本質。
- 種類5つ:リストがあり属性比較なしなら単純無作為、属性比較ありなら層化、運用を軽くしたいなら系統、リストがなければ集落・多段。
- サンプルサイズ:信頼水準95%・許容誤差5%なら母集団1万以上でも約385件。配信数は「必要回収数÷想定回答率」で逆算する。
- 最大の失敗要因:乱数ではなく抽出枠のカバレッジ誤差と無回答バイアス。リスト整備と回収率向上が精度を決める。
- 分析:単純集計→クロス集計→信頼区間の確認→検定の順。誤差幅を超えない差は「同程度」と表現する。
次のアクションとして、まずは自社の母集団規模と許容誤差から必要サンプルサイズを算出し、抽出枠のカバー率を確認してみてください。この2つが揃えば、調査設計の8割は完成です。
そのうえで、回収率と集計工数がボトルネックになりそうなら、ツールでの効率化を検討する価値があります。
▼まずは無料で試してみたい方はこちら
👉 Interviewz 無料トライアルの資料請求・お申し込みはこちら

▼機能や料金をまとめて確認したい方はこちら
👉 インタビューズ サービス概要資料を無料でダウンロード
▼調査・ヒアリングに役立つ資料をまとめて見たい方はこちら
👉 Interviewz お役立ち資料一覧を見る
▼自社の調査設計について相談したい方はこちら
👉 Interviewz お問い合わせフォームから相談する
Interviewz(インタビューズ)をご活用いただくことで以下のことが解決できます。
• 新規お問い合わせ、相談数の向上
• ヒアリングの内容の最適化から受注率の向上
• ヒアリングコスト(人件費・タイムコスト)の削減
• 既存顧客のお問い合わせのセルフ解決(サポートコストの削減)
• サービス/プロダクトのマーケティングリサーチ
• 既存顧客、従業員のエンゲージメント向上
• データ登録負荷の軽減
• サイトにおけるユーザーの行動情報のデータ蓄積
▼Interviewz(インタビューズ)の主な活用方法
• 総合ヒアリングツール
• チャットボット
• アンケートツール
• カスタマーサポートツール
• 社内FAQツール
Interviewzの機能一覧|総合的なヒアリング活動を網羅
Interviewzでは、下記のような総合的なヒアリング活動を支援する機能を揃えております。